Data Skew: qué es y cómo evitarlo
Autor
Kilian Baccaro Salinas
Categoría
Data Engineering
Tiempo de lectura
11 min de lectura
Fecha de publicación
17 sep, 2026
Si trabajas con Spark sobre grandes volúmenes de datos, tarde o temprano te vas a encontrar con el mismo síntoma: un job que debería tardar cinco minutos se queda “colgado” en la tarea 199 de 200 durante media hora. El resto de tareas terminaron hace rato. Un executor va acumulando spill a disco, puede que termine en OOM (Out of memory), y tú te quedas mirando el Spark UI sin entender por qué una sola tarea concentra todo el trabajo.
Eso es data skew: una distribución desigual de los datos entre las particiones que Spark usa para paralelizar el trabajo. No es un bug, es una consecuencia directa de cómo Spark reparte los datos cuando hace shuffle, y entender el mecanismo es la única forma de diagnosticarlo con seguridad en lugar de ir “a ciegas” subiendo memoria del executor.
Qué es un shuffle en Spark
Un shuffle es el mecanismo que usa Spark para redistribuir datos entre particiones cuando una operación necesita que las filas relacionadas
por una misma clave acaben juntas en el mismo executor. Operaciones como join, groupBy, distinct, repartition o un orderBy global no se pueden
resolver localmente: en algún punto, filas que empezaron en particiones distintas tienen que viajar hasta la partición que les
corresponde según su clave.
Ese viaje pasa por dos fases: las tareas del stage anterior escriben sus datos ya particionados a disco local (shuffle write), y las tareas del siguiente stage los leen a través de la red desde donde estén (shuffle read). Es, con diferencia, la operación más cara de un job Spark —implica I/O a disco, serialización y tráfico de red— y por eso Spark intenta evitarlo siempre que puede (por ejemplo, con un broadcast join, que se salta el shuffle por completo en uno de los dos lados).
El shuffle en sí no es el problema: es imprescindible para casi cualquier transformación no trivial. El problema es cómo se reparten los datos entre las particiones del shuffle — y ahí es donde entra el data skew.
Por qué ocurre: partición por clave de shuffle
Para decidir a qué partición va cada fila dentro de un shuffle, Spark aplica una función hash sobre la clave —la del join, la del groupBy— y
reparte el resultado entre N particiones (N viene de spark.sql.shuffle.partitions, 200 por defecto).
El problema aparece cuando la distribución de valores de esa clave no es uniforme. Algunos ejemplos típicos en un contexto de datos logísticos:
- Un
joinporcarrier_iddonde un transportista concentra el 60% del volumen y el resto se reparte entre otros 40. - Un
groupBy(warehouse_id)donde un almacén central procesa muchísimo más volumen que los regionales. - Claves nulas o por defecto (
"UNKNOWN",-1) que terminan agrupando de forma artificial un porcentaje alto de las filas.
En cualquiera de estos casos, todas las filas de esa clave dominante caen en la misma partición. Esa partición pesa mucho más que las demás, así que su tarea tarda mucho más en procesarse, necesita más memoria y, si no cabe, empieza a hacer spill a disco. El resto de tareas del stage terminan y quedan ociosas esperando a esa única tarea rezagada (lo que se conoce como straggler task).
Cómo detectarlo antes de intentar arreglarlo
Antes de aplicar cualquier técnica conviene confirmar que el problema es realmente skew y no otra cosa (undersized executors, demasiadas particiones pequeñas, etc.).
Tres formas rápidas de comprobarlo, de la más inmediata a la más manual:
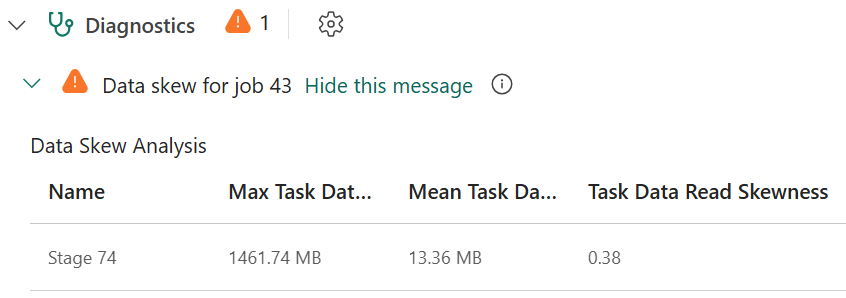
1. El panel de Diagnostics de la propia celda del notebook.
Fabric incluye un Spark Advisor que analiza cada celda en tiempo real, y si detecta skew lo muestra ahí mismo, sin salir del notebook: un aviso de “Data skew for job X” que, al expandirlo, despliega una tabla de “Data Skew Analysis” con el stage afectado, el tamaño máximo y medio de datos leídos por tarea, y un ratio de skewness. Es la forma más rápida de detectarlo porque no requiere ir a buscarlo — aparece solo junto a la celda que lo provoca.
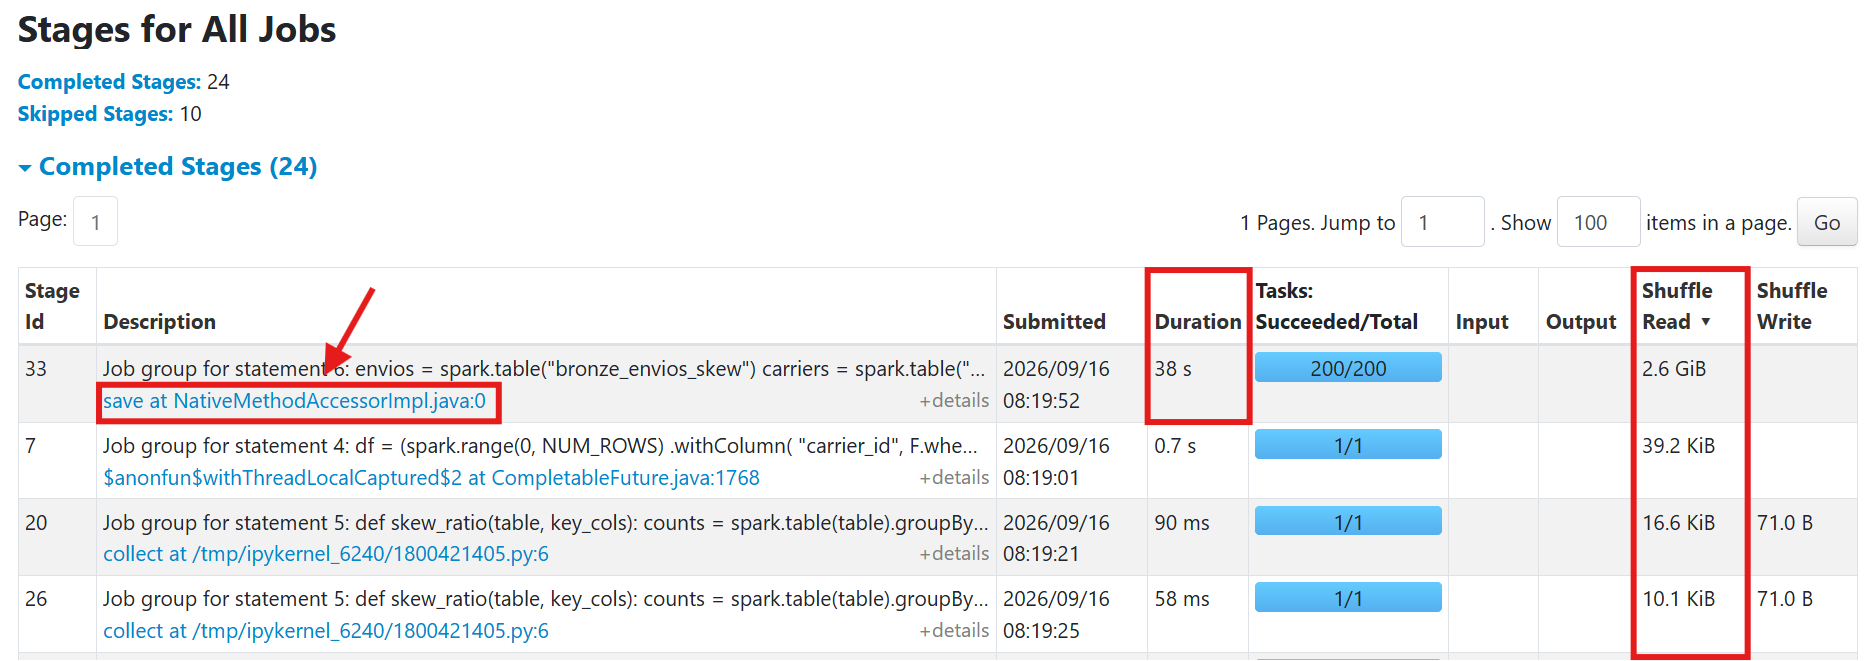
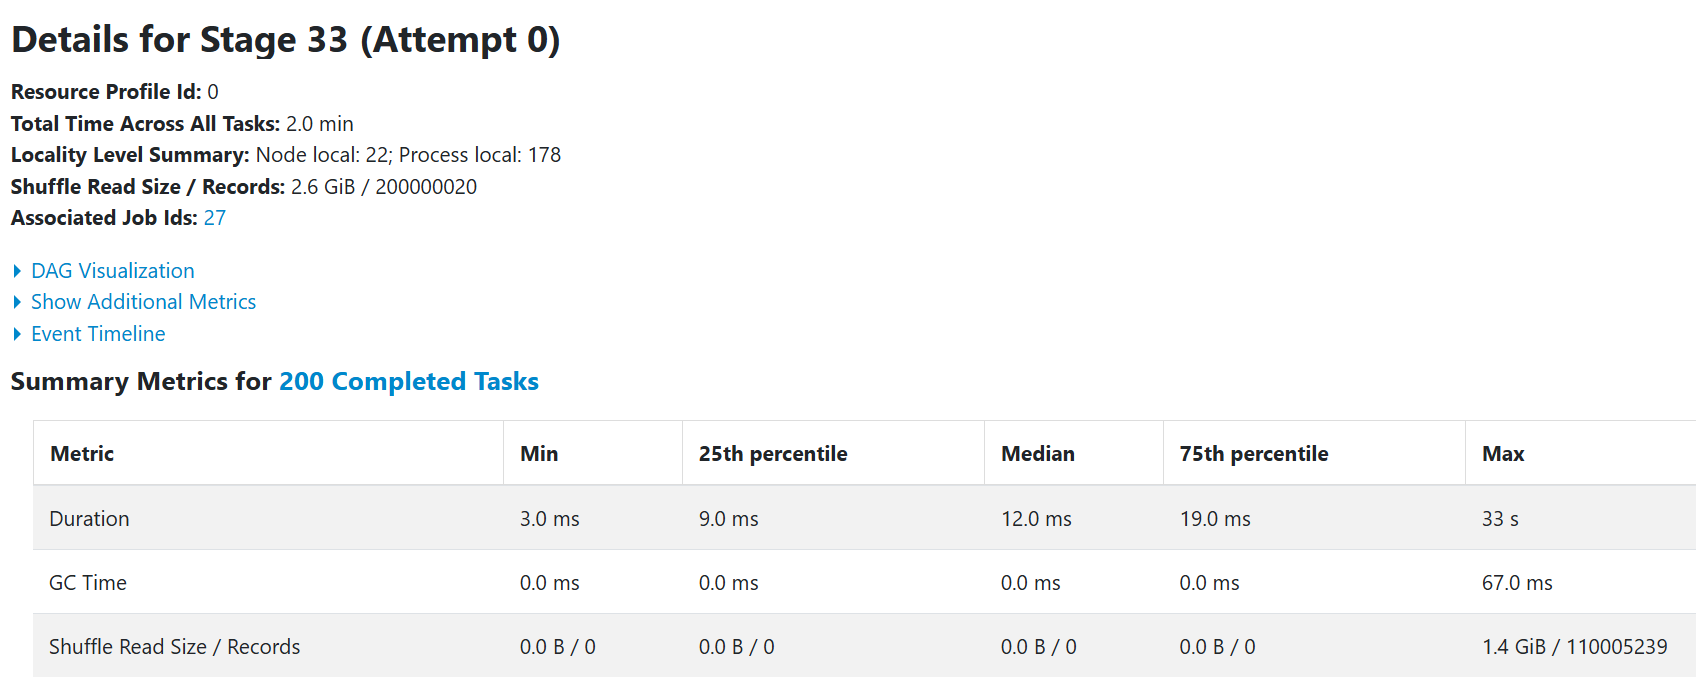
2. Spark UI / Fabric Monitoring Hub — pestaña Stages.
Si ves que la duración máxima de una tarea es varias veces la mediana, o que el “Shuffle Read Size” de una tarea es órdenes de magnitud mayor que el resto, es skew. En el detalle de la aplicación Spark dentro del Monitoring Hub de Fabric puedes ver esta misma distribución por tarea sin salir del workspace.
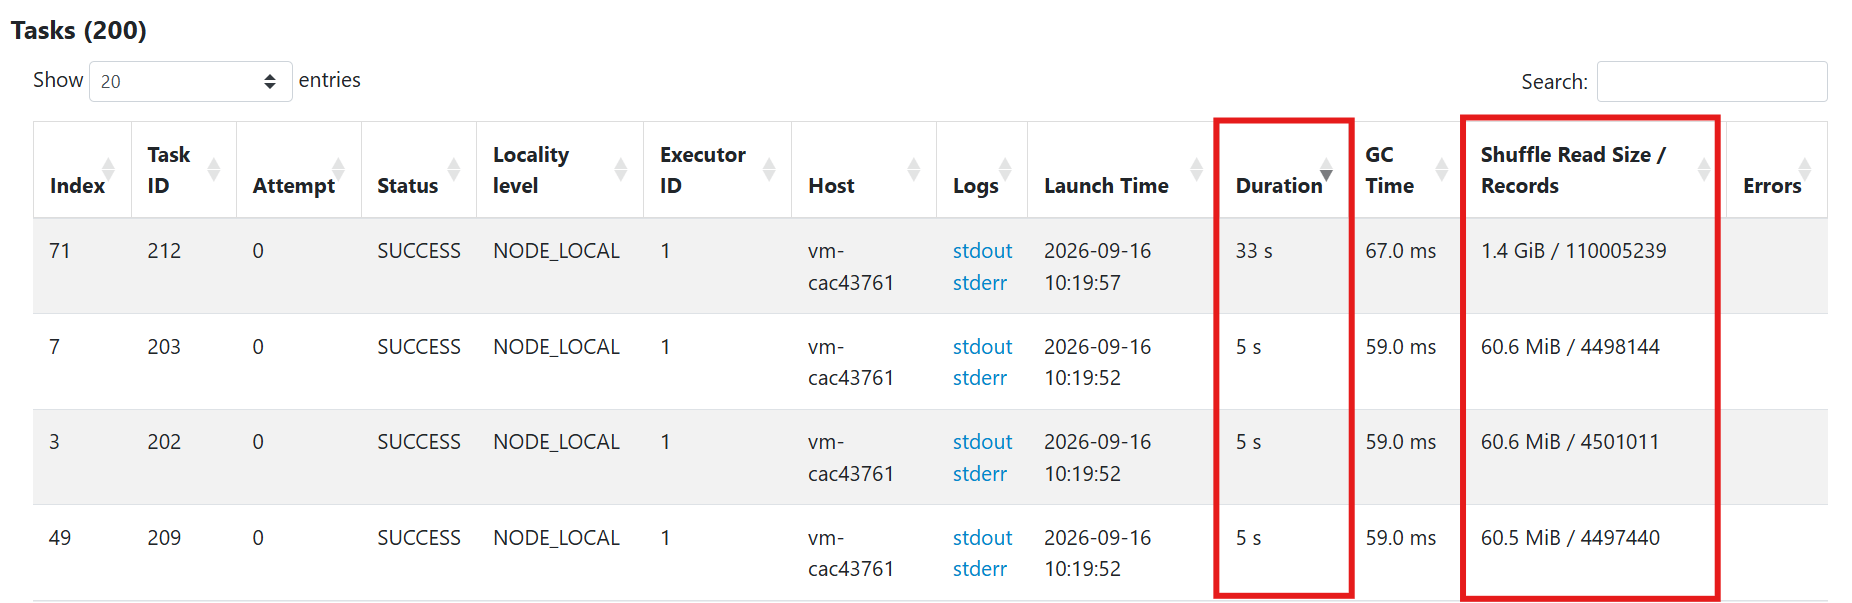
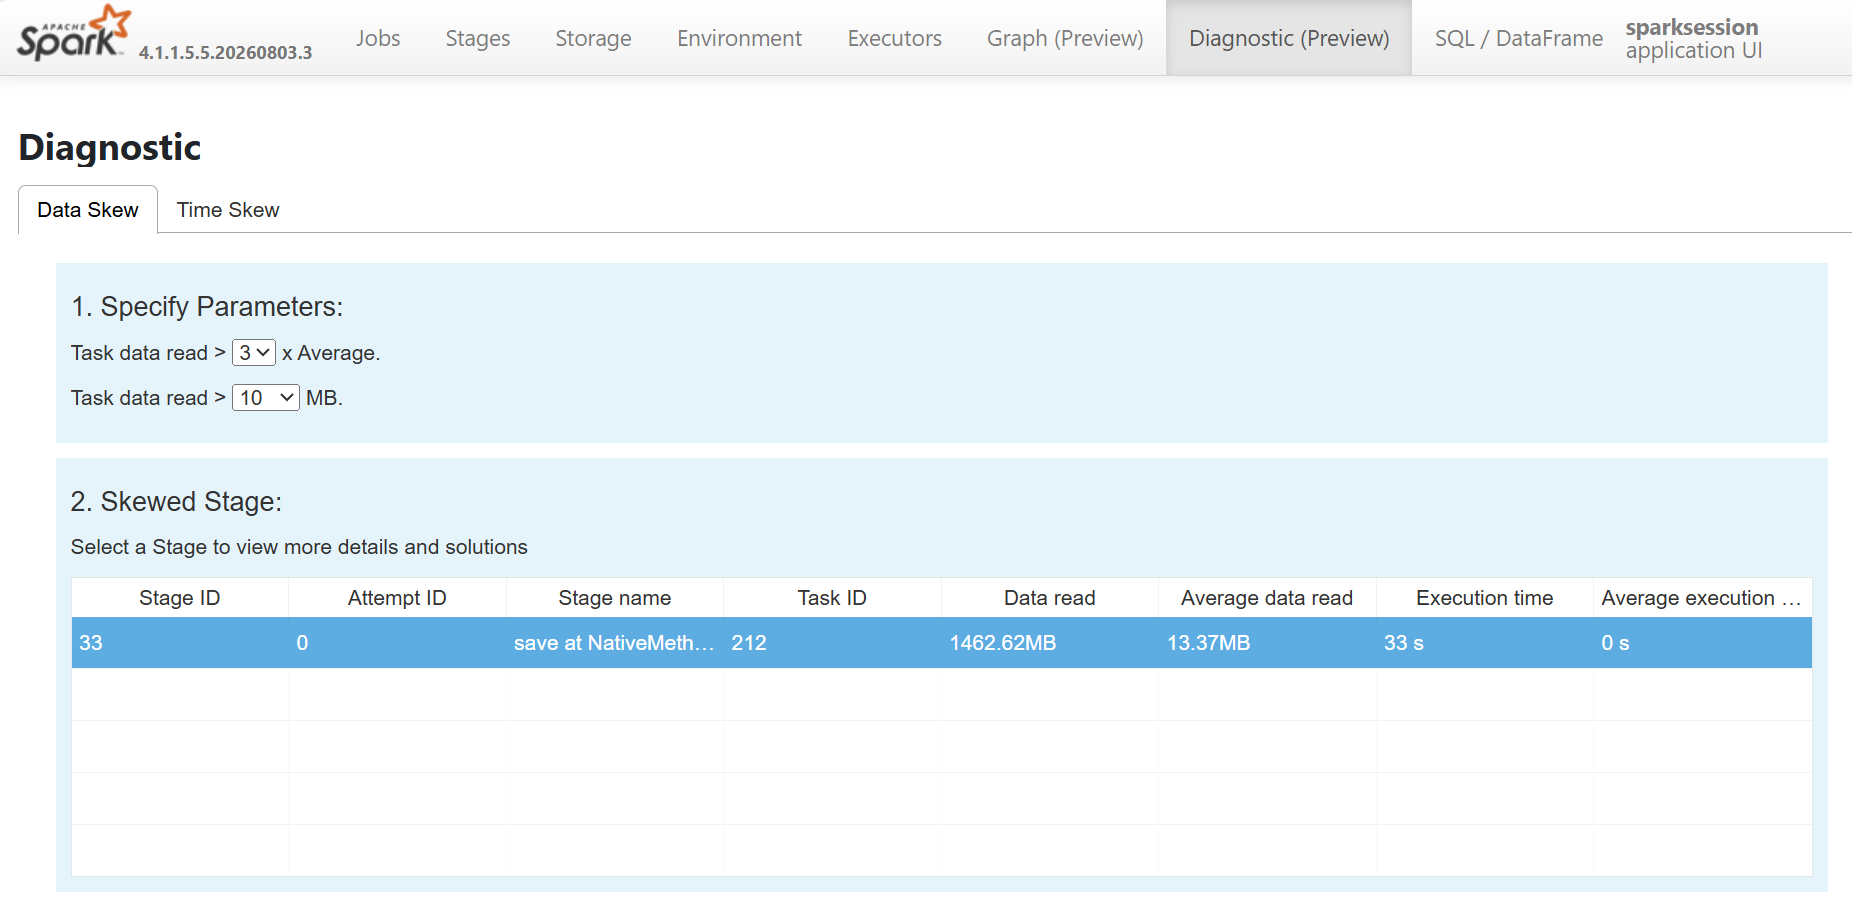
Desde esa misma aplicación Spark UI hay una forma todavía más directa: la pestaña Diagnostic (Preview) (junto a Jobs, Stages, Executors…), en su sub-pestaña Data Skew.
Ahí defines tú los umbrales —por ejemplo, “task data read > 3x la media” y ”> 10 MB”— y la herramienta te devuelve directamente el stage y la tarea que los superan, con su tamaño de datos leído y tiempo de ejecución frente a la media del stage.
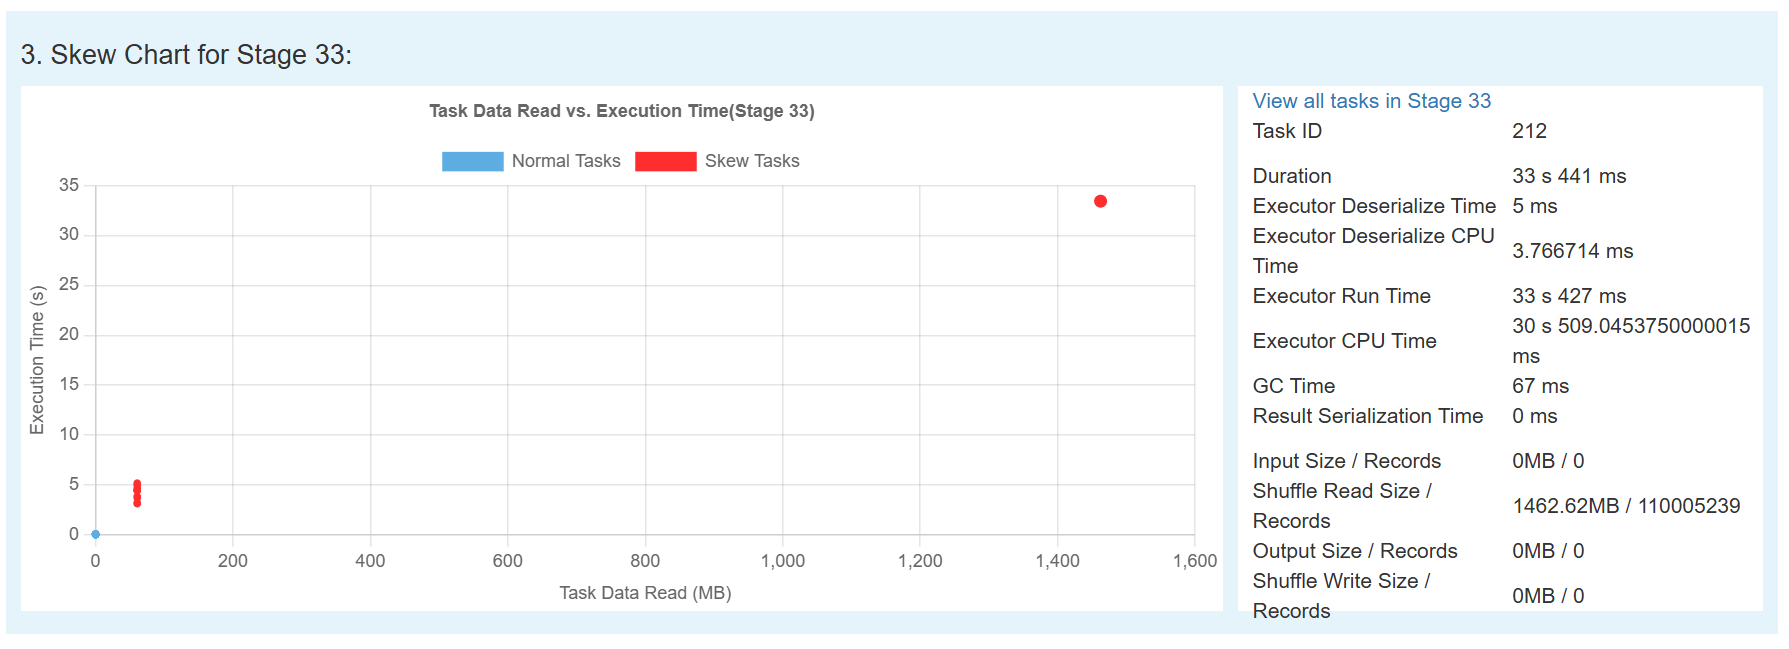
Al seleccionar un stage se abre un Skew Chart: un scatter de “Task Data Read vs. Execution Time” con las tareas normales en azul y las skewed en rojo, y al hacer clic sobre una tarea concreta se despliega su detalle completo (duración, executor run time, GC time, shuffle read/write size y número de registros).
Es la forma más rápida de ir directo al grano sin tener que ordenar manualmente la tabla de tareas por duración.
3. Un groupBy de control sobre la clave sospechosa:
(df
.groupBy("carrier_id")
.count()
.orderBy(F.col("count").desc())
.show(10, truncate=False))
Si un puñado de valores concentra un porcentaje desproporcionado de las filas frente al resto, ya tienes confirmado el origen del problema.
AQE: la primera línea de defensa
Desde Spark 3.0, Adaptive Query Execution (AQE) puede reoptimizar el plan de ejecución en tiempo real usando estadísticas reales de las etapas ya completadas, en lugar de depender solo de estimaciones previas a la ejecución. Una de sus tres optimizaciones principales es precisamente el manejo dinámico de skew en joins.
Está habilitado por defecto desde Spark 3.2.0, y el runtime de Fabric (Spark 3.4/3.5 según la versión de runtime que uses) lo trae activo de serie:
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.skewJoin.enabled", "true")
¿Cómo decide AQE que una partición está “skewed”? Compara cada partición post-shuffle contra dos umbrales, y solo actúa si ambos se superan:
spark.sql.adaptive.skewJoin.skewedPartitionFactor(por defecto5): la partición debe ser al menos 5 veces más grande que la mediana de las particiones del mismo shuffle.spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(por defecto256MB): y además debe superar este tamaño absoluto.
Cuando ambas condiciones se cumplen, AQE parte la partición skewed en sub-particiones más pequeñas y, si es necesario, replica la partición correspondiente del otro lado del join para poder unirlas correctamente. El resultado es que en lugar de una tarea gigante tienes varias tareas de tamaño similar al resto, ejecutándose en paralelo.
# Ajustar la agresividad de la detección si tu caso lo requiere
spark.conf.set("spark.sql.adaptive.skewJoin.skewedPartitionFactor", "5")
spark.conf.set("spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes", "256MB")

# Desde Spark 3.3+, forzar la optimización aunque implique shuffle adicional
spark.conf.set("spark.sql.adaptive.forceOptimizeSkewedJoin", "true")
Punto importante que se suele pasar por alto: esta optimización de AQE solo aplica a sort-merge joins. Si tu cuello de botella es un groupBy().agg() con una clave
skewed, AQE no lo va a resolver automáticamente — ahí necesitas intervenir tú mismo.
Cuando AQE no es suficiente: salting manual
El salting consiste en “diluir” artificialmente la clave skewed añadiéndole un sufijo aleatorio, de forma que las filas de esa clave dejen de caer todas en la misma partición.
Salting en una agregación (groupBy)
La clave está en hacer la agregación en dos fases: una parcial con la clave “salting” (que reparte la carga entre varias particiones) y una final que consolida el resultado quitando el salting.
from pyspark.sql import functions as F

NUM_SALT_BUCKETS = 8

df_salted = df.withColumn(
    "salt", (F.rand() * NUM_SALT_BUCKETS).cast("int")
)

# Fase 1: agregación parcial por clave + salting (se reparte entre N particiones)
partial = (df_salted
    .groupBy("warehouse_id", "salt")
    .agg(F.sum("units").alias("partial_units")))

# Fase 2: agregación final quitando el salting
result = (partial
    .groupBy("warehouse_id")
    .agg(F.sum("partial_units").alias("total_units")))
Salting en un join
Aquí el patrón es distinto: al lado skewed (normalmente la tabla grande) se le añade un salting aleatorio, y al lado pequeño se le replica una fila por cada valor posible de salting, para que el emparejamiento siga siendo correcto.
NUM_SALT_BUCKETS = 8
salt_range = F.array([F.lit(i) for i in range(NUM_SALT_BUCKETS)])

large_salted = large_df.withColumn(
    "salt", (F.rand() * NUM_SALT_BUCKETS).cast("int")
)

small_replicated = (small_df
    .withColumn("salt", F.explode(salt_range)))

result = large_salted.join(
    small_replicated,
    on=["carrier_id", "salt"],
    how="inner"
)
El salting funciona, pero no es gratis: aumenta el volumen de shuffle (en el join, literalmente multiplicas el lado pequeño por NUM_SALT_BUCKETS) y añade una etapa extra
de agregación. Úsalo cuando confirmes que AQE no cubre el caso, no como primera opción.
Ejemplo práctico: reproduciendo el skew y midiendo el impacto
Nada de esto se entiende del todo hasta que lo ves en el Spark UI.
El siguiente ejemplo genera una tabla Delta con skew simulado y compara, con tiempos reales, el join que arregla AQE solo frente a la agregación que necesita salting manual.
Los tiempos exactos van a depender de tu tamaño de cluster y del SKU de capacidad en Fabric
1. Generar una tabla Delta con skew simulado
Simulamos una tabla de envíos donde un transportista concentra más de la mitad del volumen — el patrón típico que provoca skew en un join o un groupBy por carrier_id.
from pyspark.sql import functions as F
import pandas as pd
import time

NUM_ROWS = 200_000_000        # sube a 100_000_000+ si tu capacidad lo permite
NUM_SALT_BUCKETS = 8
DOMINANT_CARRIER = "TRANSP_01"

results = {}

df = (spark.range(0, NUM_ROWS)
    .withColumn(
        "carrier_id",
        F.when(F.rand() < 0.55, F.lit(DOMINANT_CARRIER))          # ~55% concentrado en un unico transportista
         .otherwise((F.rand() * 20).cast("int").cast("string"))
    )
    .withColumn(
        "warehouse_id",
        F.when(F.rand() < 0.30, F.lit(0))                          # almacen central sobrerrepresentado
         .otherwise((F.rand() * 15).cast("int"))
    )
    .withColumn("units", (F.rand() * 100).cast("int"))
    .withColumn("order_date", F.date_sub(F.current_date(), (F.rand() * 90).cast("int")))
)

df.write.format("delta").mode("overwrite").saveAsTable("bronze_envios_skew")

# Tabla de dimension pequena para el ejemplo de join
carriers = spark.createDataFrame(
    [(str(i), f"Transportista {i}") for i in range(21)],
    ["carrier_id", "carrier_name"]
)
carriers.write.format("delta").mode("overwrite").saveAsTable("dim_carriers")
Confirma el desbalance antes de seguir:
(spark.table("bronze_envios_skew")
    .groupBy("carrier_id")
    .count()
    .orderBy(F.col("count").desc())
    .show(5))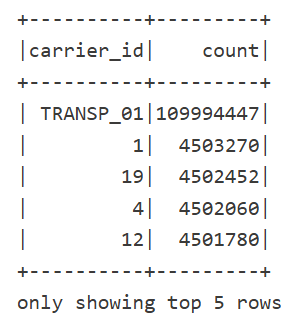
2. Join skewed: AQE actuando solo
write.format("noop") fuerza a Spark a ejecutar el plan completo sin necesidad de materializar el resultado en ningún sitio — útil para benchmarking rápido dentro de un notebook.
Un matiz que conviene tener claro antes de ejecutar esto: dim_carriers tiene solo 21 filas, muy por debajo de spark.sql.autoBroadcastJoinThreshold (10 MB por defecto).
Sin tocar nada, Spark la va a broadcastear automáticamente — esa decisión de estrategia de join se toma en la fase de planificación, antes de que AQE entre en juego,
así que ni con AQE activado ni desactivado verías shuffle ni skew en este join en concreto. Para forzar el camino real de shuffle + sort-merge join (el que AQE optimiza)
hay que desactivar el broadcast automático en este bloque:
envios = spark.table("bronze_envios_skew")
carriers = spark.table("dim_carriers")

# Forzamos sort-merge join desactivando el broadcast automático; si no,
# Spark broadcastea dim_carriers sin pasar por shuffle y no hay skew que ver.
spark.conf.set("spark.sql.autoBroadcastJoinThreshold", "-1")

# Desactivamos AQE solo como punto de comparación
spark.conf.set("spark.sql.adaptive.enabled", "false")

t0 = time.time()
envios.join(carriers, "carrier_id").write.format("noop").mode("overwrite").save()
print(f"Join sin AQE: {time.time() - t0:.1f}s")

spark.conf.set("spark.sql.adaptive.enabled", "true")
t0 = time.time()
envios.join(carriers, "carrier_id").write.format("noop").mode("overwrite").save()
print(f"Join con AQE: {time.time() - t0:.1f}s")
Join sin AQE: 49.6s
Join con AQE: 31.4sCon AQE desactivado, en el Spark UI vas a ver una tarea del stage del join tardando muchísimo más que el resto.
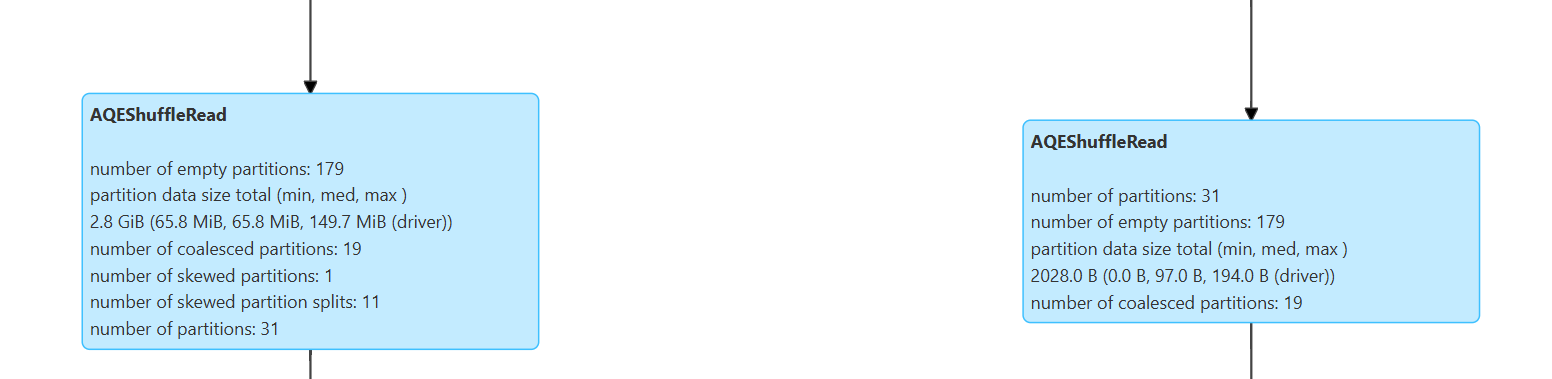
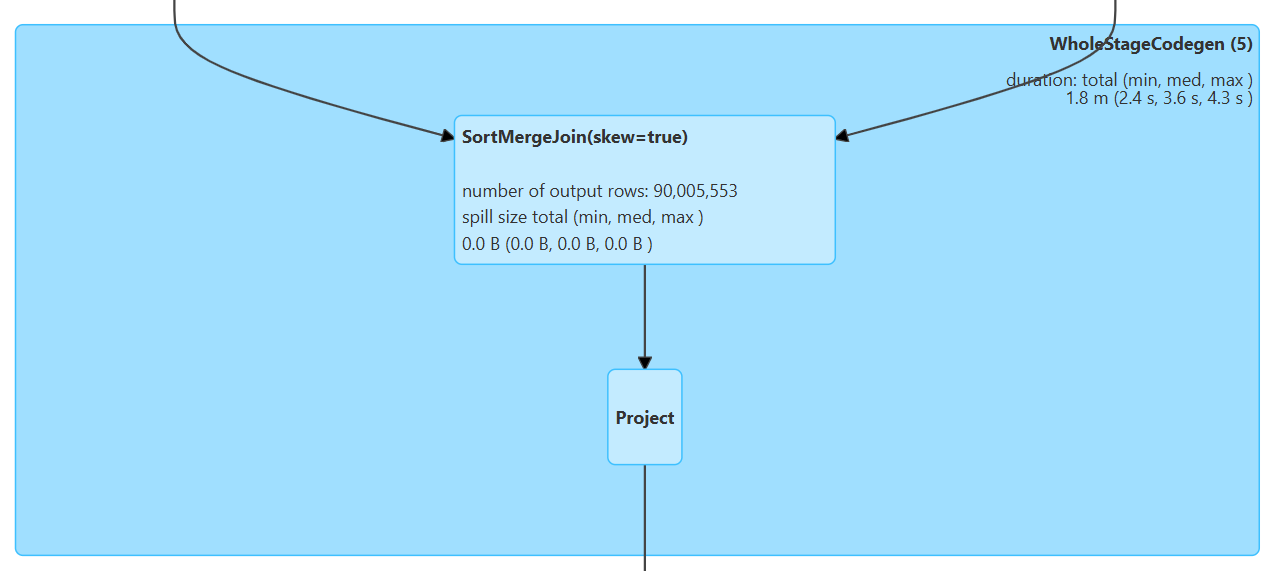
Con AQE activado, abre el plan de ejecución (.explain(), o la pestaña SQL / DataFrame del Spark UI) y busca dos señales inequívocas:
- El propio join aparece anotado como SortMergeJoin(skew=true)
- El operador de lectura del shuffle se llama AQEShuffleRead (en Spark 3.2 y anteriores se llamaba CustomShuffleReader; el nombre cambió en la 3.3).
En el nodo AQEShuffleRead, verás el detalle exacto —number of skewed partitions y number of skewed partition splits— que confirma cuántas particiones detectó como skewed y en cuántas sub-particiones dividió cada una.
3. Agregación skewed: AQE no ayuda, aplicamos salting
df = spark.table("bronze_envios_skew")

# AQE sigue activo, pero esto es una agregación pura — no un join
t0 = time.time()
(df.groupBy("carrier_id")
   .agg(F.sum("units").alias("total_units"))
   .write.format("noop").mode("overwrite").save())
print(f"GroupBy sin salting: {time.time() - t0:.1f}s")

NUM_SALT_BUCKETS = 8
df_salted = df.withColumn("salt", (F.rand() * NUM_SALT_BUCKETS).cast("int"))

partial = (df_salted
    .groupBy("carrier_id", "salt")
    .agg(F.sum("units").alias("partial_units")))

t0 = time.time()
(partial.groupBy("carrier_id")
    .agg(F.sum("partial_units").alias("total_units"))
    .write.format("noop").mode("overwrite").save())
print(f"GroupBy con salting: {time.time() - t0:.1f}s")
Aquí el Spark UI es aún más revelador:
- En el stage de la agregación sin salting verás una única tarea con un “Shuffle Read” muy superior al resto.
- Con salting, la carga se reparte entre
NUM_SALT_BUCKETStareas de tamaño similar en la fase parcial, y la fase final —mucho más ligera porque ya está pre-agregada— vuelve a agrupar porcarrier_idsin coste relevante.
4. Qué mirar exactamente en el Spark UI
- Stages → Task duration: compara el “Max” contra la mediana. Si el skew está resuelto, ambos valores deberían quedar mucho más próximos.
- Stages → Shuffle Read: mismo patrón — la tarea que antes destacaba por tamaño debería desaparecer.
- SQL / DataFrame plan: busca
SortMergeJoin(skew=true)y el operadorAQEShuffleRead(indican que AQE detectó y reescribió el plan) y compara el número de particiones antes/después. En el propio nodoAQEShuffleReadmuestranumber of skewed partitionsynumber of skewed partition splits.
Otras estrategias que conviene tener a mano
-
Broadcast join: si uno de los dos lados del join es lo bastante pequeño para caber en memoria de cada executor, fuerza un broadcast en lugar de un shuffle join. Por defecto Spark lo hace automáticamente si el tamaño estimado está por debajo de
spark.sql.autoBroadcastJoinThreshold(10 MB por defecto), y con AQE activo esta decisión se puede tomar también en tiempo de ejecución, no solo con estadísticas previas.Ojo con esto al diagnosticar: la elección de broadcast ocurre en la fase de planificación, antes de que AQE actúe — si tu tabla “grande” está unida contra una dimensión que ya cabe en el umbral, nunca vas a ver skew en ese join, se resuelva o no AQE esté activado. Si quieres forzar el camino de shuffle para comprobar el comportamiento con y sin AQE, baja
autoBroadcastJoinThresholda-1temporalmente. -
Aislar la clave dominante: si el skew viene de un único valor claramente identificable (por ejemplo, un
carrier_idque concentra la mitad del volumen), puedes filtrar ese valor, procesarlo por separado —con su propio particionado— y haceruniondel resultado con el resto. Es más código, pero a veces es más simple y predecible que el salting. -
Repartition explícito por clave:
df.repartition(N, "carrier_id")no elimina el skew en sí (las filas de la misma clave seguirán en la misma partición), pero te permite controlar el número de particiones y, combinado con salting, es la base para repartir de forma más uniforme. -
Revisar valores nulos o por defecto: si buena parte del skew viene de
NULLo de un valor DESCONOCIDO, plantéate si esas filas necesitan participar en el join/agregación o si se pueden tratar aparte.
Limitaciones y puntos a vigilar
- AQE resuelve skew en joins, no en agregaciones (
groupBy,distinct,window functions); para esas necesitas salting o rediseñar la clave de agrupación. - Bajar demasiado
skewedPartitionThresholdInByteshace que Spark divida particiones que en realidad no eran un problema real, generando overhead innecesario. Ajusta con cabeza y valida con el Spark UI. - El salting cambia la clave física, así que después de la fase parcial es fácil introducir errores de doble conteo si no se hace la agregación final correctamente. Valida los resultados contra una muestra antes de llevarlo a producción.
- Después de aplicar cualquiera de estas técnicas, vuelve al Spark UI (o al Monitoring Hub en Fabric) y confirma que la distribución de duración entre tareas se ha equilibrado — no des el problema por resuelto solo porque el job “ya no falla”.
Conclusión
El data skew no se soluciona subiendo memoria del executor ni añadiendo más nodos al pool de Spark — casi siempre es un problema de distribución de la clave, no de capacidad. AQE cubre automáticamente el caso más común (joins skewed) sin que tengas que tocar nada, y eso resuelve la mayoría de los casos en Fabric. Cuando el skew está en una agregación, o es tan extremo que ni el split automático de AQE es suficiente, el salting manual —aunque añade complejidad y shuffle— es la herramienta que te permite recuperar el paralelismo real del cluster.
Referencias
- Performance Tuning – Adaptive Query Execution, Apache Spark docs
- Apache Spark runtime in Fabric – Microsoft Learn
- Monitor Spark jobs within a notebook (Spark Advisor) – Microsoft Learn
- Spark best practices: development and monitoring – Microsoft Learn
- Adaptive Query Execution: Speeding Up Spark SQL at Runtime – Databricks Engineering Blog
Artículos relacionados
Conectar a un data lake desde Microsoft Fabric y copiar su contenido a un lakehouse

Cómo usar Fabric Notebooks desde local con VS Code