Fabric AI Functions: enriquece DataFrames con LLMs en una sola línea de PySpark
Autor
Kilian Baccaro Salinas
Categoría
Inteligencia Artificial
Tiempo de lectura
08 min de lectura
Fecha de publicación
25 sep, 2026
Clasificar tickets, resumir reseñas o extraer campos de texto libre son tareas cada vez más habituales en un pipeline de datos. Hacerlo con un LLM desde Spark implica montar el cliente contra Azure OpenAI, controlar concurrencia, reintentos y límites de tokens, y decidir cómo repartir todo eso en el clúster.
Las AI Functions de Microsoft Fabric encapsulan esa parte. Se exponen como una transformación más sobre un DataFrame, df.ai.<función>(), y por debajo
lanzan cientos de llamadas asíncronas al modelo manteniendo el aislamiento del contenido a nivel de fila. Fabric se encarga del endpoint del modelo integrado,
así que no hace falta desplegar ni autenticar nada para empezar.
En este artículo me centro en la API de PySpark: qué funciones hay, cómo configurarlas (incluido Runtime 2.0), un ejemplo de extremo a extremo con reseñas de Steam, y lo que conviene saber sobre concurrencia, consumo de capacidad y limitaciones antes de meterlas en producción.
Funciones disponibles
Son nueve, y todas siguen el mismo patrón: una columna de entrada, una de salida y parámetros propios de cada función.
| Función | Para qué sirve |
|---|---|
ai.analyze_sentiment | Etiquetar el sentimiento (positivo, negativo, mixto o neutral). Admite etiquetas personalizadas |
ai.classify | Clasificar texto en las etiquetas que tú defines |
ai.embed | Generar vectores de embeddings para búsqueda semántica, recuperación o ML |
ai.extract | Extraer campos (nombres, ubicaciones, entidades propias). Con ExtractLabel puedes tipar la salida |
ai.fix_grammar | Corregir ortografía, gramática y puntuación |
ai.generate_response | Ejecutar un prompt libre sobre cada fila. Con response_format devuelve salida estructurada |
ai.similarity | Comparar el significado de un texto con un valor de referencia u otra columna (de -1 a 1) |
ai.summarize | Resumir texto, ficheros o filas completas. El parámetro instructions controla tono, longitud o foco |
ai.translate | Traducir a otro idioma |
No reproduzco aquí los parámetros de cada una; la documentación oficial enlaza el detalle en versión pandas y PySpark.
Dónde se pueden usar
- Notebooks, con las APIs de pandas y PySpark.
- Warehouse y SQL analytics endpoint, con funciones T-SQL como
ai_summarize,ai_classifyoai_generate_response. - Dataflow Gen2, mediante Fabric AI Prompt en Power Query.
Además del texto, pueden trabajar con ficheros (imágenes, PDF y ficheros de texto como CSV, JSON o XML) indicando el tipo de columna como ruta (input_col_type o col_types en PySpark), y hay helpers como aifunc.load, aifunc.list_file_paths y ai.infer_schema. Eso da para un artículo aparte; el detalle está en la documentación multimodal.
Requisitos y modelo por defecto
- Un administrador debe habilitar el tenant switch de Copilot y otras características basadas en Azure OpenAI.
- Según tu región, puede ser necesario habilitar el procesamiento cross-geo.
- Capacidad de pago: F2 o superior, o cualquier P.
- Fabric Runtime 1.3 o posterior.
El modelo por defecto es gpt-5-mini con reasoning_effort en low (400.000 tokens de contexto y 128.000 de salida máxima). Según la documentación, las AI Functions no registran ni almacenan los prompts, los datos de entrada ni las salidas.
Configuración en PySpark
import synapse.ml.spark.aifunc as aifuncCon ese import, el accessor .ai queda disponible en cualquier DataFrame de Spark.
Fabric Runtime 2.0 (Spark 4.1)
Si trabajas con Runtime 2.0, la documentación pide incluir al inicio de la sesión una configuración que describe como workaround temporal para paquetes afectados del runtime. En PySpark no hay que instalar nada, solo fijar modelo y parámetros:
import synapse.ml.spark.aifunc as aifunc

aifunc.default_conf.set_deployment_name("gpt-5.1")  # o "gpt-5-mini"
aifunc.default_conf.set_reasoning_effort("low")
aifunc.default_conf.reset_temperature()
Estas celdas deben ir al principio de cada sesión hasta que una actualización del runtime elimine la necesidad.
Con pandas el workaround es distinto: hay que instalar nest_asyncio en una celda aparte (que reinicia Python) y, para ejecuciones programadas o de pipeline, añadir nest-asyncio a un Fabric environment en lugar de usar %pip.
Al ser un workaround temporal, revisa la página de Runtime 2.0 antes de llevarlo a producción por si ya no aplica.
Ejemplo práctico: reseñas de Steam
El escenario: partimos de un CSV de reseñas de Steam con, al menos, el nombre del juego (app_name) y el texto de la reseña (review_text).
Queremos convertir ese texto libre en atributos analizables (sentimiento y tema) y generar después un resumen de las quejas por juego.
1. Datos de partida
Antes de llamar al modelo hay dos decisiones que conviene tomar desde el principio, porque afectan directamente al coste:
- Trabajar con una muestra. Un CSV de reseñas puede tener millones de filas y no tiene sentido lanzar las AI Functions sobre todo el dataset en la primera prueba. Aquí tomo los tres juegos con más reseñas y 50 reseñas al azar entre ellos.
- Acotar los tokens por fila. El
substringa 1.000 caracteres limita el texto que se envía al modelo; las reseñas más largas se cortan. Ajusta el límite a tu caso.
reviews = (
    spark.read.format("csv").option("header","true").load("Files/ai_functions/steam_reviews.csv")
        .select("app_name", "review_text")
        .filter(F.col("app_name").isNotNull())
        .filter(F.col("review_text").isNotNull() & (F.length(F.trim("review_text")) > 20))
        .withColumn("review_text", F.substring("review_text", 1, 1000))
)

top_games = (
    reviews.groupBy("app_name").count()
    .orderBy(F.desc("count"))
    .limit(3)
    .select("app_name")
)

top_games.show()

sample = (
    reviews.join(top_games, "app_name")
    .orderBy(F.rand(seed=42))
    .limit(50)
)

sample.show()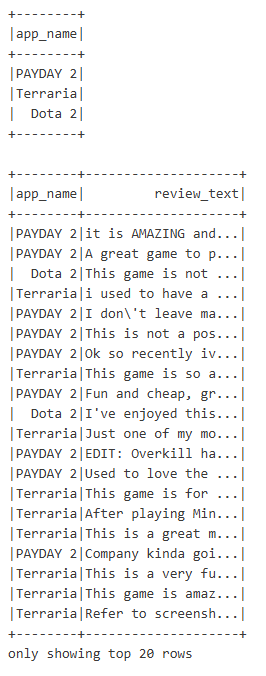
2. Enriquecimiento: sentimiento y tema
Las funciones de PySpark devuelven un DataFrame que mantiene el accessor .ai, así que se pueden encadenar sin materializar DataFrames intermedios
Conviene que las etiquetas de classify sean estables (aquí en inglés y en minúsculas) para poder filtrar y agregar después sin normalizar variantes, e incluir una etiqueta comodín como other para lo que no encaje.
enriched = (
    sample
    .ai.analyze_sentiment(input_col="review_text", output_col="sentiment")
    .ai.classify(
        labels=["gameplay", "graphics", "performance", "story", "price", "multiplayer", "bugs", "other"],
        input_col="review_text",
        output_col="topic",
    )
)
display(enriched)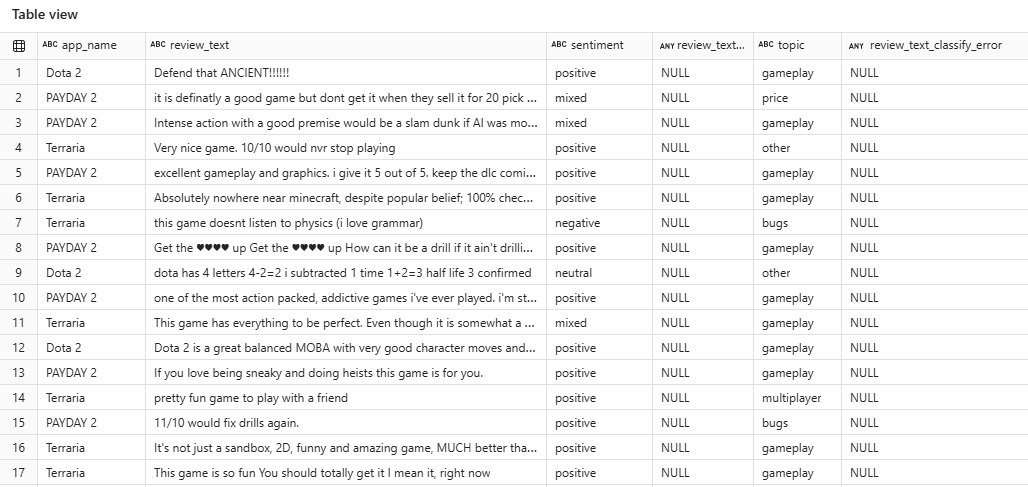
3. Revisar el consumo con ai.stats
Tras ejecutar las funciones, ai.stats sobre el DataFrame resultado devuelve las métricas de ejecución:
Estos son los campos que más interesan:
num_successful,num_exceptions,num_unevaluatedynum_harmful: filas procesadas, con error, no evaluadas por un error previo y bloqueadas por el filtro de contenido de Azure OpenAI.input_tokens,output_tokens,cached_tokensyreasoning_tokens: consumo de tokens.model: modelo utilizado.
Las filas con error, bloqueadas por el filtro o sin capacidad se representan en el resultado como objetos especiales (aifunc.ExceptionResult, aifunc.FilterResult, aifunc.CapacityExceededResult). Por eso conviene mirar num_exceptions y num_harmful antes de dar por bueno el resultado y decidir qué hacer con esas filas.
display(enriched.ai.stats)
4. Del texto libre a atributos
Con sentimiento y tema ya como columnas, lo que sigue es Spark de siempre. La idea de fondo es esa: el LLM convierte texto libre en atributos, y a partir de ahí se agrega, filtra y une como cualquier otro dato.
enriched_tbl = spark.read.table("steam_reviews_enriched")

# Comprueba los valores reales antes de filtrar por ellos
display(enriched_tbl.groupBy("sentiment").count())

by_game = (
    enriched_tbl
    .groupBy("app_name")
    .agg(
        F.count("*").alias("n_reviews"),
        F.round(F.avg((F.col("sentiment") == "negative").cast("int")), 2).alias("pct_negative"),
    )
)

negative_topics = (
    enriched_tbl
    .filter(F.col("sentiment") == "negative")
    .groupBy("app_name", "topic")
    .count()
    .orderBy("app_name", F.desc("count"))
)

display(by_game)
display(negative_topics)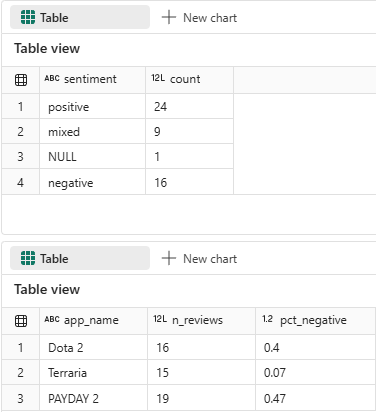
5. Resumen de quejas por juego
ai.generate_response recibe un prompt y los datos de la fila. Para acotar tokens, agrupamos por juego un máximo de 20 reseñas negativas en una sola columna y generamos un resumen para el equipo de producto:
negatives_by_game = (
    enriched_tbl
    .filter(F.col("sentiment") == "negative")
    .groupBy("app_name")
    .agg(
        F.concat_ws("\n---\n", F.slice(F.collect_list("review_text"), 1, 20)).alias("negative_reviews")
    )
)

briefs = negatives_by_game.ai.generate_response(
    prompt=(
        "A partir de las reseñas de la columna negative_reviews, resume en tres frases "
        "las quejas principales de los jugadores sobre el juego indicado en app_name. "
        "No incluyas información que no aparezca en las reseñas."
    ),
    output_col="feedback_brief",
)

display(briefs)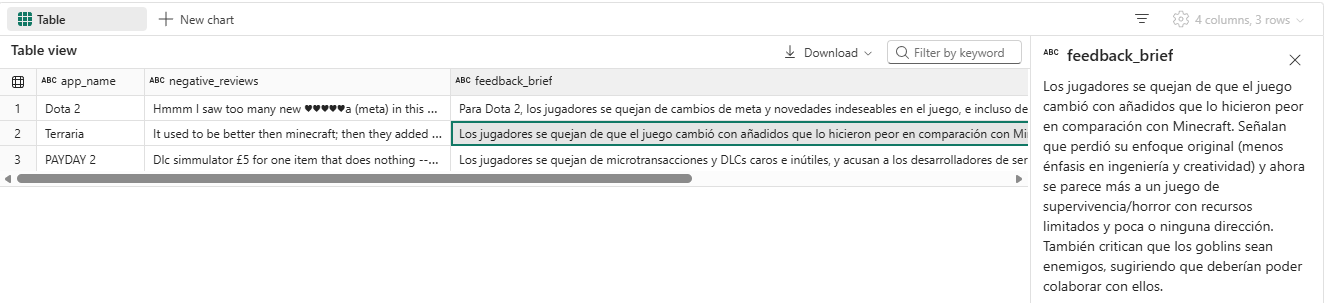
Si necesitas una salida estructurada (por ejemplo, JSON con campos concretos), generate_response admite response_format; los ejemplos están en la documentación de PySpark.
Concurrencia, modelo y consumo
Concurrencia
El parámetro concurrency fija cuántas filas se procesan en paralelo con peticiones asíncronas al modelo. Por defecto es 200, puede llegar a 1.000 y se define por llamada a la función:
results = sample.ai.analyze_sentiment(
    input_col="review_text",
    output_col="sentiment",
    concurrency=100,
)
En Spark, este valor se aplica a cada worker. El paralelismo total hacia el modelo crece, por tanto, con el número de workers, y subirlo solo acelera el proceso si tu capacidad lo admite. Empieza con una muestra y ajusta.
Cambiar de modelo
El modelo se fija de forma global con aifunc.default_conf o por llamada, usando el nombre del parámetro en camelCase y sin el prefijo set_ (por ejemplo, deploymentName="gpt-5.1"):
aifunc.default_conf.set_deployment_name("gpt-5.1")
aifunc.default_conf.set_reasoning_effort("medium")  # minimal, low, medium, high
aifunc.default_conf.set_verbosity("low")            # low, medium, high
Dos detalles de la documentación:
- Los modelos de la serie GPT-5 solo admiten el valor por defecto de
temperature. - La serie GPT-4.1 se está retirando. Si tenías pipelines fijados a
gpt-4.1, la recomendación es migrar agpt-5.1; los fijados agpt-4.1-mini, agpt-5-mini.
También puedes usar tu propio endpoint (Azure OpenAI o Microsoft Foundry) con set_URL y set_subscription_key, y modelos no OpenAI de Foundry con api_type="chat_completions". Ten en cuenta que los modelos de Foundry deben aceptar response_format con JSON schema, y que ai.embed y ai.similarity no están soportadas con un recurso Foundry personalizado. La clave no debería vivir en el notebook: guárdala en Azure Key Vault.
Consumo de capacidad
Con el endpoint integrado, las llamadas al modelo se facturan a la capacidad bajo el medidor Copilot and AI y aparecen en la Capacity Metrics app como la operación AI Functions. El cómputo de Spark que orquesta el notebook se factura aparte, con el medidor de Spark. Si usas un endpoint propio, Fabric no cobra las llamadas al modelo (las cobra tu proveedor), pero el cómputo de Fabric sigue aplicando.
El consumo depende de los tokens, con tarifas distintas para entrada, entrada en caché y salida:
| Modelo | Entrada (por 1.000 tokens) | Entrada en caché | Salida |
|---|---|---|---|
gpt-5-mini | 8,40 CU s | 0,84 CU s | 67,23 CU s |
gpt-5.1 | 42,02 CU s | 4,20 CU s | 336,13 CU s |
Un cálculo ilustrativo, con 1 millón de tokens de entrada y 200.000 de salida (sin caché):
gpt-5-mini: 8.400 + 13.446 ≈ 21.846 CU s.gpt-5.1: 42.020 + 67.226 ≈ 109.246 CU s, unas cinco veces más.
Son cifras de ejemplo, no una estimación de tu carga. Las tarifas están sujetas a cambios y la documentación de billing no detalla cómo se contabilizan los reasoning_tokens, que ai.stats muestra por separado. Lo más fiable es ejecutar una muestra representativa, mirar ai.stats y contrastarlo con la operación AI Functions en la Capacity Metrics app antes de escalar.
Limitaciones a tener en cuenta
- No determinismo. La misma fila puede producir salidas distintas entre ejecuciones y el modelo puede equivocarse. Los propios ejemplos de Microsoft incluyen la advertencia de revisar siempre la salida. No construyas lógica crítica sobre columnas derivadas por IA sin validarlas, y usa los Eval Notebooks para medir la calidad antes de producción.
- Valores nulos. Las funciones
classifyoanalyze_sentimentpueden devolver nulo cuando no consiguen decidir. Comprueba si esto te ocurre y añade una etiqueta comodín (por ejemploother) y un tratamiento de nulos aguas abajo. - Idioma. Es posible que la mayoría de funciones estén optimizadas para inglés. Con el modelo actual conviene validar con tus propios datos en español en lugar de asumir la calidad.
- Datos personales. Que las AI Functions no almacenen los datos no exime de revisar qué envías al modelo. La página de Runtime 2.0 advierte de que la redacción de PII basada en un modelo puede pasar por alto datos personales, así que no debería ser tu única barrera.
- Capacidad. Necesitas F2 o superior, y las filas que exceden los límites de capacidad se devuelven como
CapacityExceededResult. Hay que detectarlas y reintentarlas. - Runtime 2.0. El workaround es temporal. Revísalo en cada actualización del runtime.
- No todo es un problema para un LLM. Si la transformación se resuelve con una expresión regular, un join contra una tabla de referencia o una regla, será más barata y más reproducible.
Conclusión
Las AI Functions reducen a una línea lo que antes era un pequeño proyecto de ingeniería: cliente, concurrencia, reintentos y distribución en Spark. Lo que no eliminan es la responsabilidad sobre la calidad y el coste: hay que revisar el prompt, medir tokens con ai.stats, materializar resultados y tratar las filas que fallan.
Como punto de partida, prueba con una muestra pequeña, valida las salidas con tus datos reales y solo después escala la concurrencia y el volumen.